这本书想解决什么
一条能走通的路线按时间轴讲,一章一个年代
每个算法都放回它被发明时面对的那个问题里:快排是因为早期排序太慢,Dijkstra 是因为要找最短路,Transformer 是因为 RNN 没法并行。知道了痛点,算法就不再是要背的结论。
第 3 章先打地基
第 3 章用 31 节把数据结构一次讲透:数组、链表、栈、队列、哈希表、树、堆、图、并查集、Trie。为什么同样是查找,哈希表是 O(1)、有序数组是 O(log n)、链表只能 O(n)?答案都在这一章。
零基础也能从第 0 章读起
第 0 章用煮鸡蛋、贴标签的盒子、编号的抽屉讲清变量、列表、循环、递归与复杂度,不假设任何编程基础;书中所有英文缩写第一次出现都带中文解释。
配套 82 个可改代码的仿真
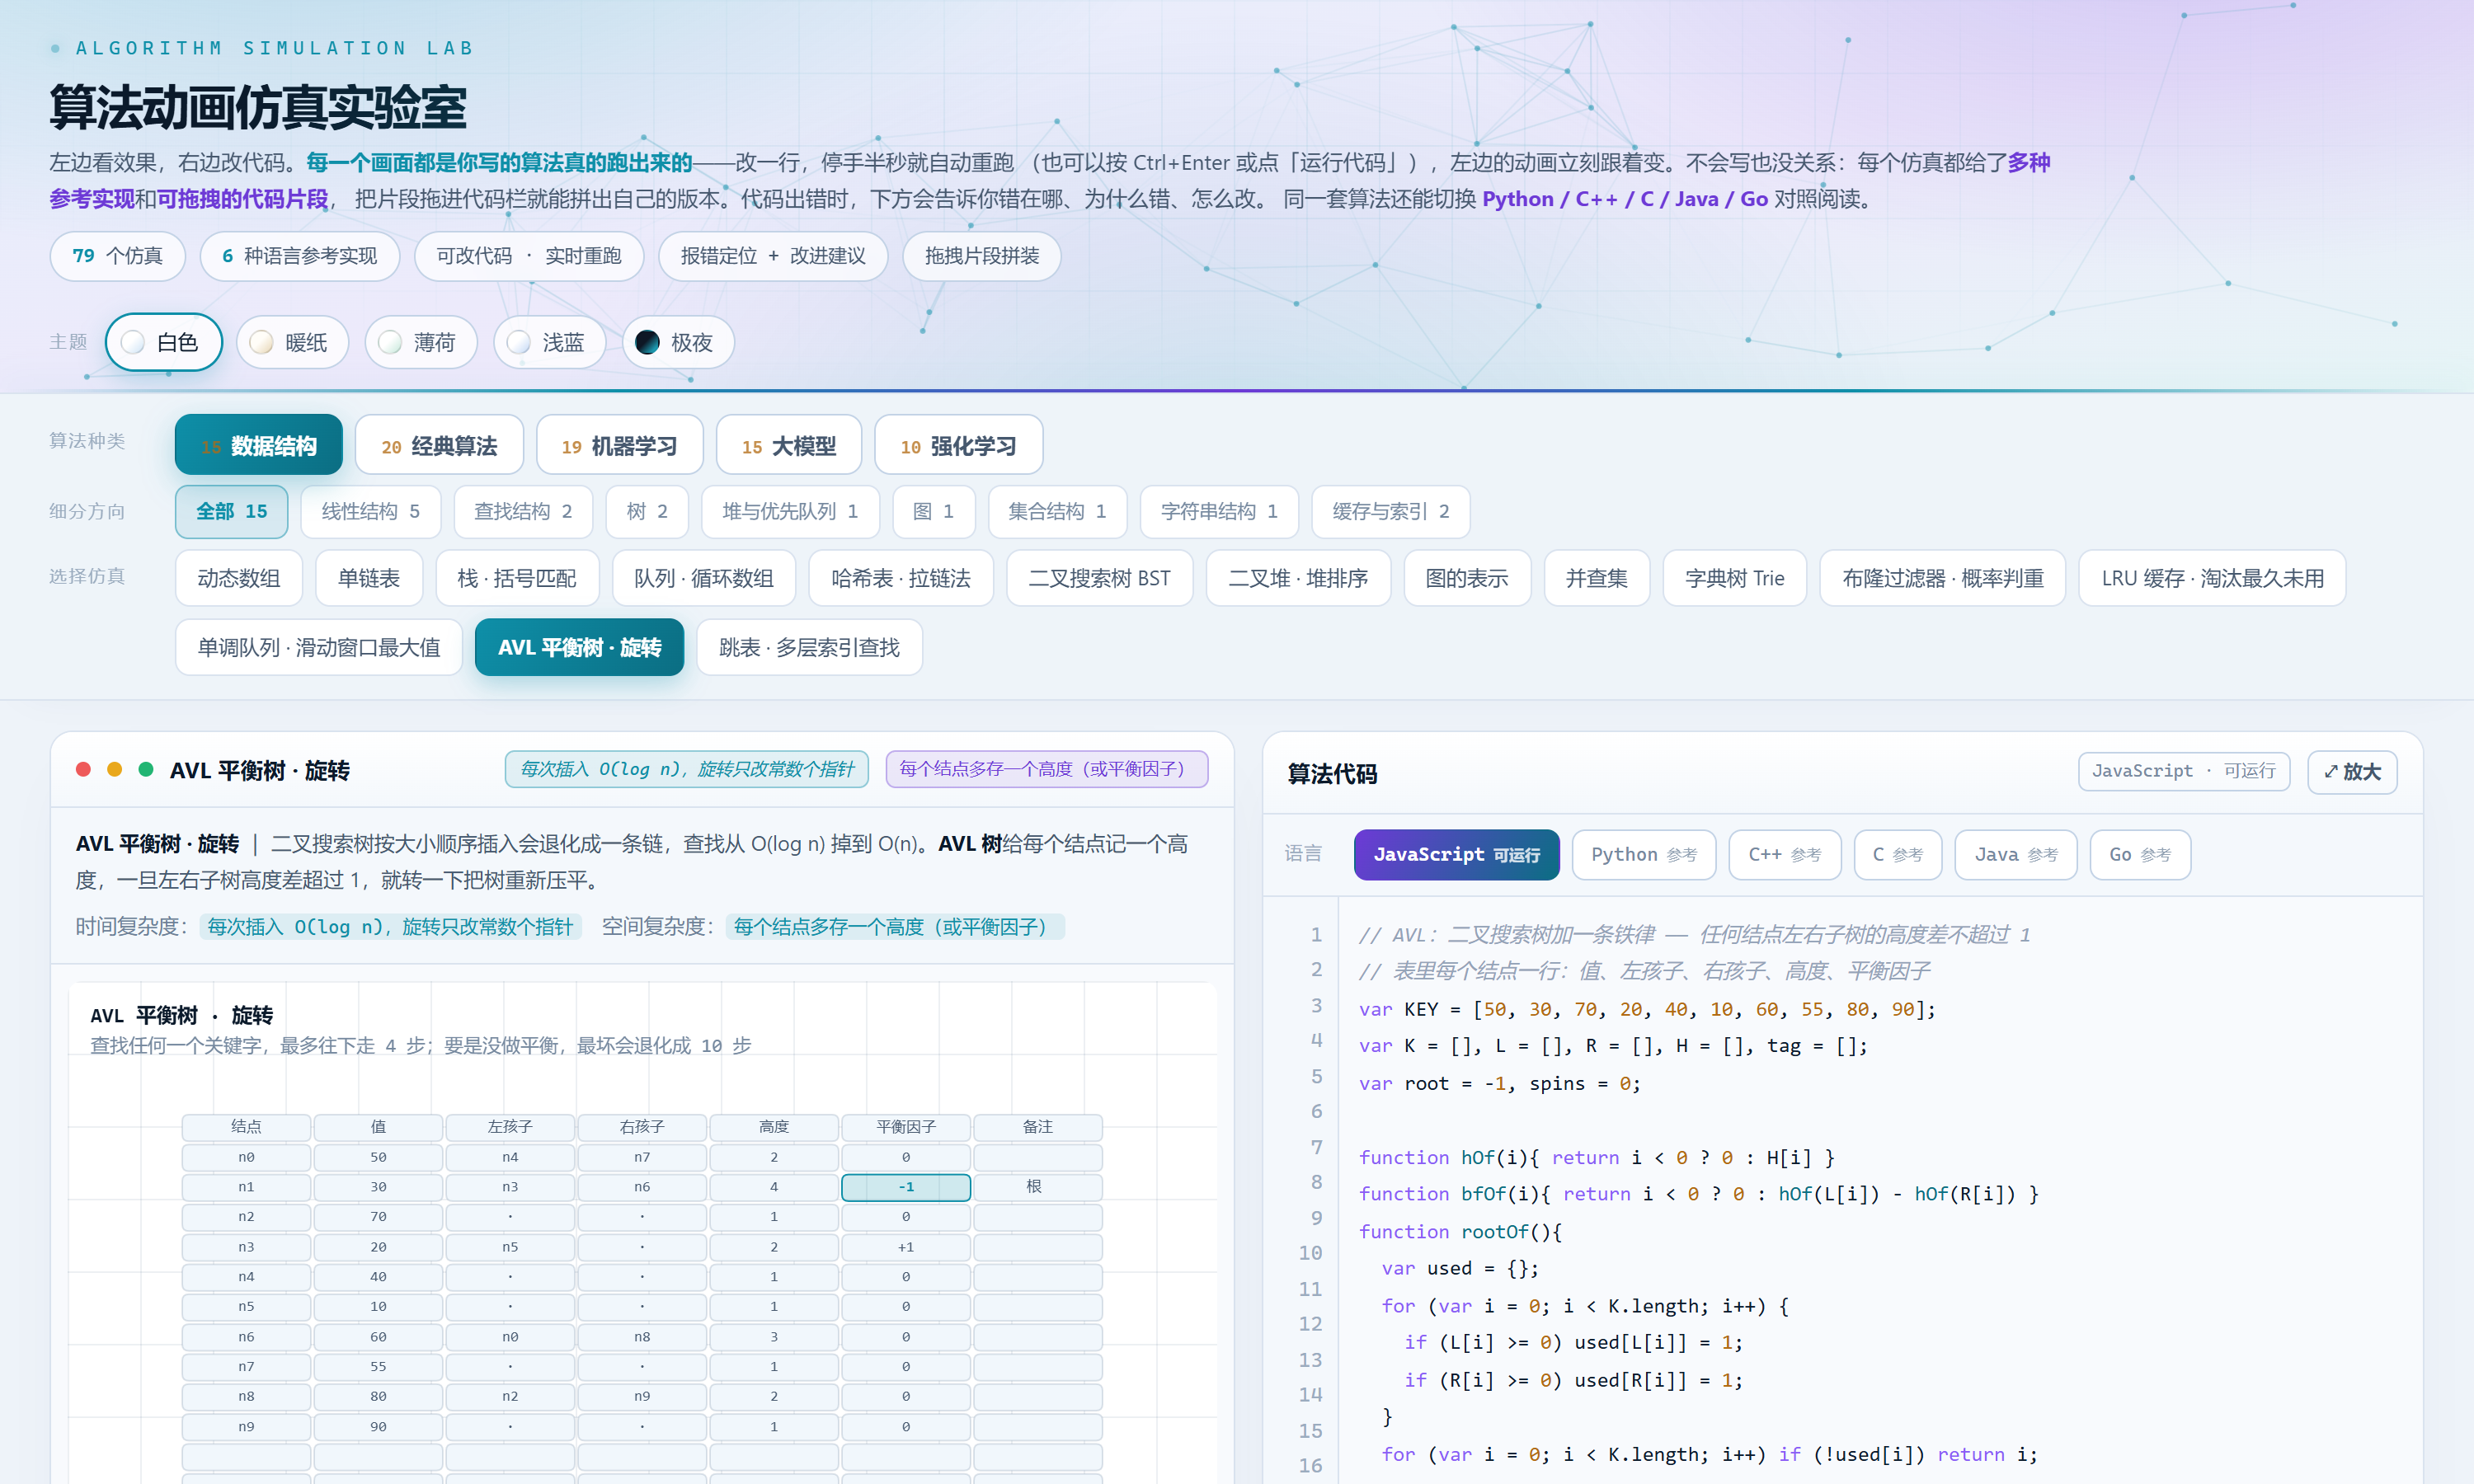
左栏看执行效果、右栏改代码,改完立刻重跑;下方给出报错位置与修改建议,还能把代码片段拖进代码栏拼出自己的版本。数据结构 15 个、经典算法 23 个、机器学习 19 个、大模型 15 个、强化学习 10 个;每个仿真都能切换 C / C++ / Python / Java / JavaScript / Go 六种语言的完整参考实现。
落到「能怎么用」上
复杂度速查表、超参数速查、算力与显存估算公式、按场景选算法的决策清单、七个最常见的坑,以及六个真实场景的选型推理——可以直接当案头手册翻。
也讲什么时候不该用
每一章末尾都有「本章常见错误与练习」,把踩过的坑写清楚:数据泄漏、忘了梯度清零、奖励函数被钻空子、二分区间写不清、哈希退化……比正面讲原理更有用。
第 2 版新增:数据结构专章 + 七个附录
上一版 11 章、约 7.6 万字;本版 12 章、 204 节、 312 页、 7 个附录第 3 章 数据结构:算法的地基
数据结构是本书唯一无法跳过的前置知识。这一章用 27 节把二十多个结构一次讲透, 每个结构都回答四个问题:它长什么样(内存怎么安排)、增删改查各要多久、适合什么场景、代价是什么。 全部配可运行的手写实现与选型对照表,读完再回头看后面的算法,很多「为什么」会自己浮出来。
第 2 版增补:3.15 线段树、3.16 树状数组、3.17 红黑树、3.18 B+ 树、3.19 字符串哈希与后缀数组、3.20 带权并查集、3.22 LRU、3.23 位图、3.24 概率数据结构、3.25 可持久化结构;4.19 双指针与滑动窗口 → 4.25 数论基础;5.15 特征工程 → 5.18 正则化的几何直觉;6.8 激活函数;7.13 蒙特卡罗与 TD、7.14 探索策略与奖励设计;8.15 位置编码的演进、8.16–8.18 手写自注意力与提示工程工程化。第三轮增补:1.3 两数之和六种解法、1.6–1.8 阅读地图与 12 问速答、2.5–2.7 三个真实故事与三条暗线、3.27–3.30 手写哈希表 / 堆 / 并查集与 21 个结构选型总表、4.26–4.28 背包六讲与手推快排、5.22–5.26 手推线性回归 / 混淆矩阵 / 手推决策树 / 不平衡处理 / 怎么读论文、6.12–6.14 从零写一个神经网络 / 梯度消失实测 / 三个旋钮、9.11–9.13 微调落地 / 评测三级方案 / 幻觉治理、10.7–10.8 三条约束选型与落地清单、11.4–11.7 30 天与 90 天路线。全部小节都配了同名仿真。附录 A 术语中英对照(约 200 条)、附录 B 代码模板速查(10 个)、附录 C 仿真对照表(81 行)、附录 D 复杂度与选型总表(4 张)、附录 E 练习题与解题思路(42 题)、附录 F 调试与排错手册、附录 G 常用数学公式速查。
配套仿真:左边看效果,右边改代码
书里每一个结构都可以在浏览器里跑起来。左边是动画与执行过程(数组、链表、树、图、散列桶、注意力权重……), 右边是可以直接编辑的代码:改一行、点一次运行,左边的画面立刻跟着变。 代码写错时,下方会指出错误在哪一行、为什么错、可以怎么改,并给出与你手写实现相比的效率对比。
不会写也没关系:每个仿真都提供「参考实现」下拉(同一算法的不同实现路径,例如快速排序的随机基准版、堆排序版), 以及一排可以拖拽的代码片段——把片段拖进代码栏就能拼出自己的版本;随时可以一键重置回默认实现。 顶部还可以切换 C / C++ / Python / Java / JavaScript / Go 六种语言的同题实现,右侧「参考实现」下拉给出同一算法的多种写法(递归 / 迭代、随机基准 / 三路划分、朴素 / 加速版);页面另带五套明暗主题可随时切换。
全书目录
12 章 · 204 节 · 7 个附录 · 312 页预备知识:什么都不懂也能从这里开始
用煮鸡蛋讲清算法的三个要求(有限、精确、可执行),再补上 6 个编程概念与 4 个数学概念,最后教你怎么读复杂度记号。
导言:这份文档怎么用
三条并行演进的谱系,以及一个贯穿全书的判断标准:不要问哪个算法更强,要问它匹配的是什么约束。
算法发展时间轴(1945—2026)
把八十年的关键算法放在同一条轴上,看到每个算法替代了谁、又被谁替代,以及背后的三条规律。
数据结构:算法的地基第 2 版新增
数组、链表、栈、队列、哈希表、树、堆、图、并查集、Trie 这十个基础结构讲到能手写,再连着补上线段树、树状数组、红黑树、B+ 树、后缀数组、带权并查集、LRU 缓存、位图、布隆过滤器、可持久化结构。每个结构都给出复杂度对照、选型建议与一个真实场景,最后用 3.26 六个案例把选型过一遍,再用 3.27~3.29 把哈希表、堆、并查集亲手写一遍,3.30 做横向对比,3.31 用洪水填充收尾。
经典算法:确定性问题的解法第 2 版扩充
排序、二分、Dijkstra、A*、动态规划、贪心、布隆过滤器、PageRank,再加上排序家族全览、KMP、最小生成树、单调栈、霍夫曼编码、基数排序、最长递增子序列,以及双指针与滑动窗口、前缀和与差分、二分答案、回溯与剪枝、分治、状态压缩与数论基础。
机器学习算法:从数据中学规律
线性回归与岭回归、逻辑回归、决策树、随机森林、GBDT、AdaBoost、SVM、KNN、K-Means、DBSCAN、高斯混合,以及评估指标该怎么选。
深度学习:让模型自己学表示
多层感知机与反向传播、优化器演化、正则化与归一化、CNN、RNN/LSTM/GRU,以及 VAE、GAN 与扩散模型。
强化学习:在试错中学决策
MDP、贝尔曼方程、Q-learning 与 DQN、SARSA、TD(λ) 资格迹、Double DQN、REINFORCE 到 PPO,以及探索与利用的权衡和三大流派横向对比。
Transformer 与大语言模型(LLM)全书最厚
从「预测下一个 token」讲到自注意力、多头注意力、因果掩码、位置编码、Scaling Law、三阶段训练、LoRA、RLHF 与 DPO、推理加速、KV Cache、采样策略、RAG 与 Agent。
2025—2026 前沿进展:从拼规模到拼效率
混合架构与 MoE、稀疏注意力、推理预算可调节、蒸馏与 1-bit 量化、Agent 产业化,以及哪些是原理层面的变化、哪些只是工程。
选型指南与性能参数总表第 2 版扩充
复杂度速查、关键超参数速查、算力与显存估算公式、按场景选算法的决策清单、七个最常见的坑,以及六个真实场景的选型推理。
学习路线与结语
三阶段学习路径(能写 → 能选型 → 能做系统)、一句话总结每个算法家族,以及最后的三条判断。
附录 A 核心术语中英对照表第 2 版新增
复杂度、数据结构、算法范式、机器学习、深度学习与大模型、强化学习——中文名、英文缩写、一句话解释三列对照,随时回来查。
附录 B 常用代码模板速查第 2 版新增
二分查找、并查集、Top-K 堆、图遍历、拓扑排序、Dijkstra、滑动窗口、回溯、快速幂、0-1 背包——可以直接抄进程序用的最小骨架。
附录 C 82 个仿真与章节对照第 2 版新增
每个仿真对应哪一小节、主要观察什么,一目了然;想动手就从数据结构组开始,想直接体验大模型就跳到 LLM 组。
附录 D 复杂度与选型总表第 2 版新增
数据结构操作、排序、图算法、机器学习与深度学习模型,全部压成四张表,每一行都标了时间、空间与适用边界。不记得复杂度的时候直接翻这里。
附录 E 练习题与解题思路第 2 版新增
每道题都给「怎么想起来的」而不只是答案:先看出它是哪个模式(哈希、双指针、动态规划、并查集……),再决定用什么结构。
附录 F 调试与排错手册第 2 版新增
「程序报错」与「能跑但结果不对」两条主线索,加上九个最常见的具体坑,最后是一份可以打印出来贴在桌前的排查清单。
附录 G 常用数学公式速查第 2 版新增
复杂度与增长、概率与统计、线性代数与微积分、工程估算公式,再加一张符号速查表——读公式时随时回查。